Jev: kleine AI-beslissingen die je software verder helpen
Waarom ontwikkelaars ermee experimenteren, wat een organisatie eraan kan hebben en hoe je de eerste toepassing bouwt.
Een klant schrijft: ‘De levering is er nog steeds niet. Als het vandaag niet lukt, annuleer dan maar.’
Je applicatie moet nu een paar dingen weten. Gaat dit naar logistiek of klantenservice? Vraagt de klant om annulering, of stelt hij een voorwaarde? Welke vervolgstap mag de software voorbereiden?
Voor die eerste beoordeling heb je taalbegrip nodig. Voor de orderstatus heb je je ERP nodig. En voor het daadwerkelijk annuleren heb je bedrijfsregels, bevoegdheden en een betrouwbare koppeling nodig.
Precies bij dat taalbegrip wordt Jev interessant. Het model van TypeSafe geeft software kleine, gestructureerde oordelen waarmee gewone code verder kan werken. Als tech lead wil ik vooral weten of dat een bruikbaar onderdeel van onze toepassingen kan worden: bij klantvragen, documentverwerking en het vinden van de juiste informatie.
Wat Jev doet
TypeSafe bracht Jev op 15 september 2026 uit in early access. Het bedrijf noemt het een System One-model: een model voor snelle, afgebakende beoordelingen. Je geeft het context en vragen. Het antwoord bestaat uit waarden die je applicatie direct kan verwerken. Jev schrijft geen e-mail, programmeert geen functie en levert geen uitgeschreven redenering.
Een verzoek bevat twee belangrijke onderdelen. In state zet je de informatie die nodig is om te oordelen, bijvoorbeeld een klantbericht en de definities van je afdelingen. In questions beschrijf je wat je wilt weten en welke antwoorden mogelijk zijn.
Daarvoor zijn er drie bouwstenen:
- Choice: kies één van de opgegeven opties. Bijvoorbeeld facturatie, levering of overig. Je krijgt ook de kansen per optie terug.
- Noul: beoordeel een ja/nee-vraag en geef de kans op ‘ja’. Bijvoorbeeld: bevat het bericht een verzoek om annulering?
- Score: beoordeel iets op een beschreven schaal. Bijvoorbeeld van ‘niet relevant voor deze vraag’ tot ‘beantwoordt de vraag rechtstreeks’. De score volgt uit kansen over die niveaus; het is geen vervanging voor een exacte berekening.
De documentatie over deze bouwstenen helpt je kiezen. Voor meerdere kenmerken die tegelijk kunnen gelden, gebruik je afzonderlijke vragen. Een bericht kan immers zowel over een levering gaan als om annulering vragen.
Waarom ontwikkelaars er nu mee bezig zijn
Sinds de introductie zijn er openbare projecten verschenen voor e-mail, documenten en data-import. Die passen Jev toe op een herkenbaar programmeerprobleem: software kan prima vertakken zodra de invoer duidelijk is, maar vrije tekst laat zich moeilijk in een paar betrouwbare regels vangen.
TypeSafe heeft de modelarchitectuur en uitvoering gericht op dit soort beoordelingen. Volgens de lanceringspublicatie gebruikt Jev een parallelle sampler en een trainingsmethode genaamd Reinforcement Learning for Calibrated Decisions, of RLCD. Het doel is beslissingen met bruikbare waarschijnlijkheden, zonder eerst een reeks antwoordtokens uit te schrijven. Dat is de uitleg van de leverancier; de publicatie geeft geen volledig reproduceerbaar trainingsrecept.
Die beperkte uitvoer maakt het aantrekkelijk om AI op meer plekken in software te proberen. Je kunt een bericht beoordelen terwijl het binnenkomt, een document bij de juiste workflow aanbieden of een gevonden passage controleren voordat die naar een antwoordmodel gaat.
LLM’s kunnen met structured outputs ook antwoorden binnen een schema leveren. De technische afweging gaat daarom verder dan geldig JSON: vergelijk de kwaliteit van de beoordeling, de wachttijd, de kosten en de mogelijkheden om onzekere gevallen af te handelen.
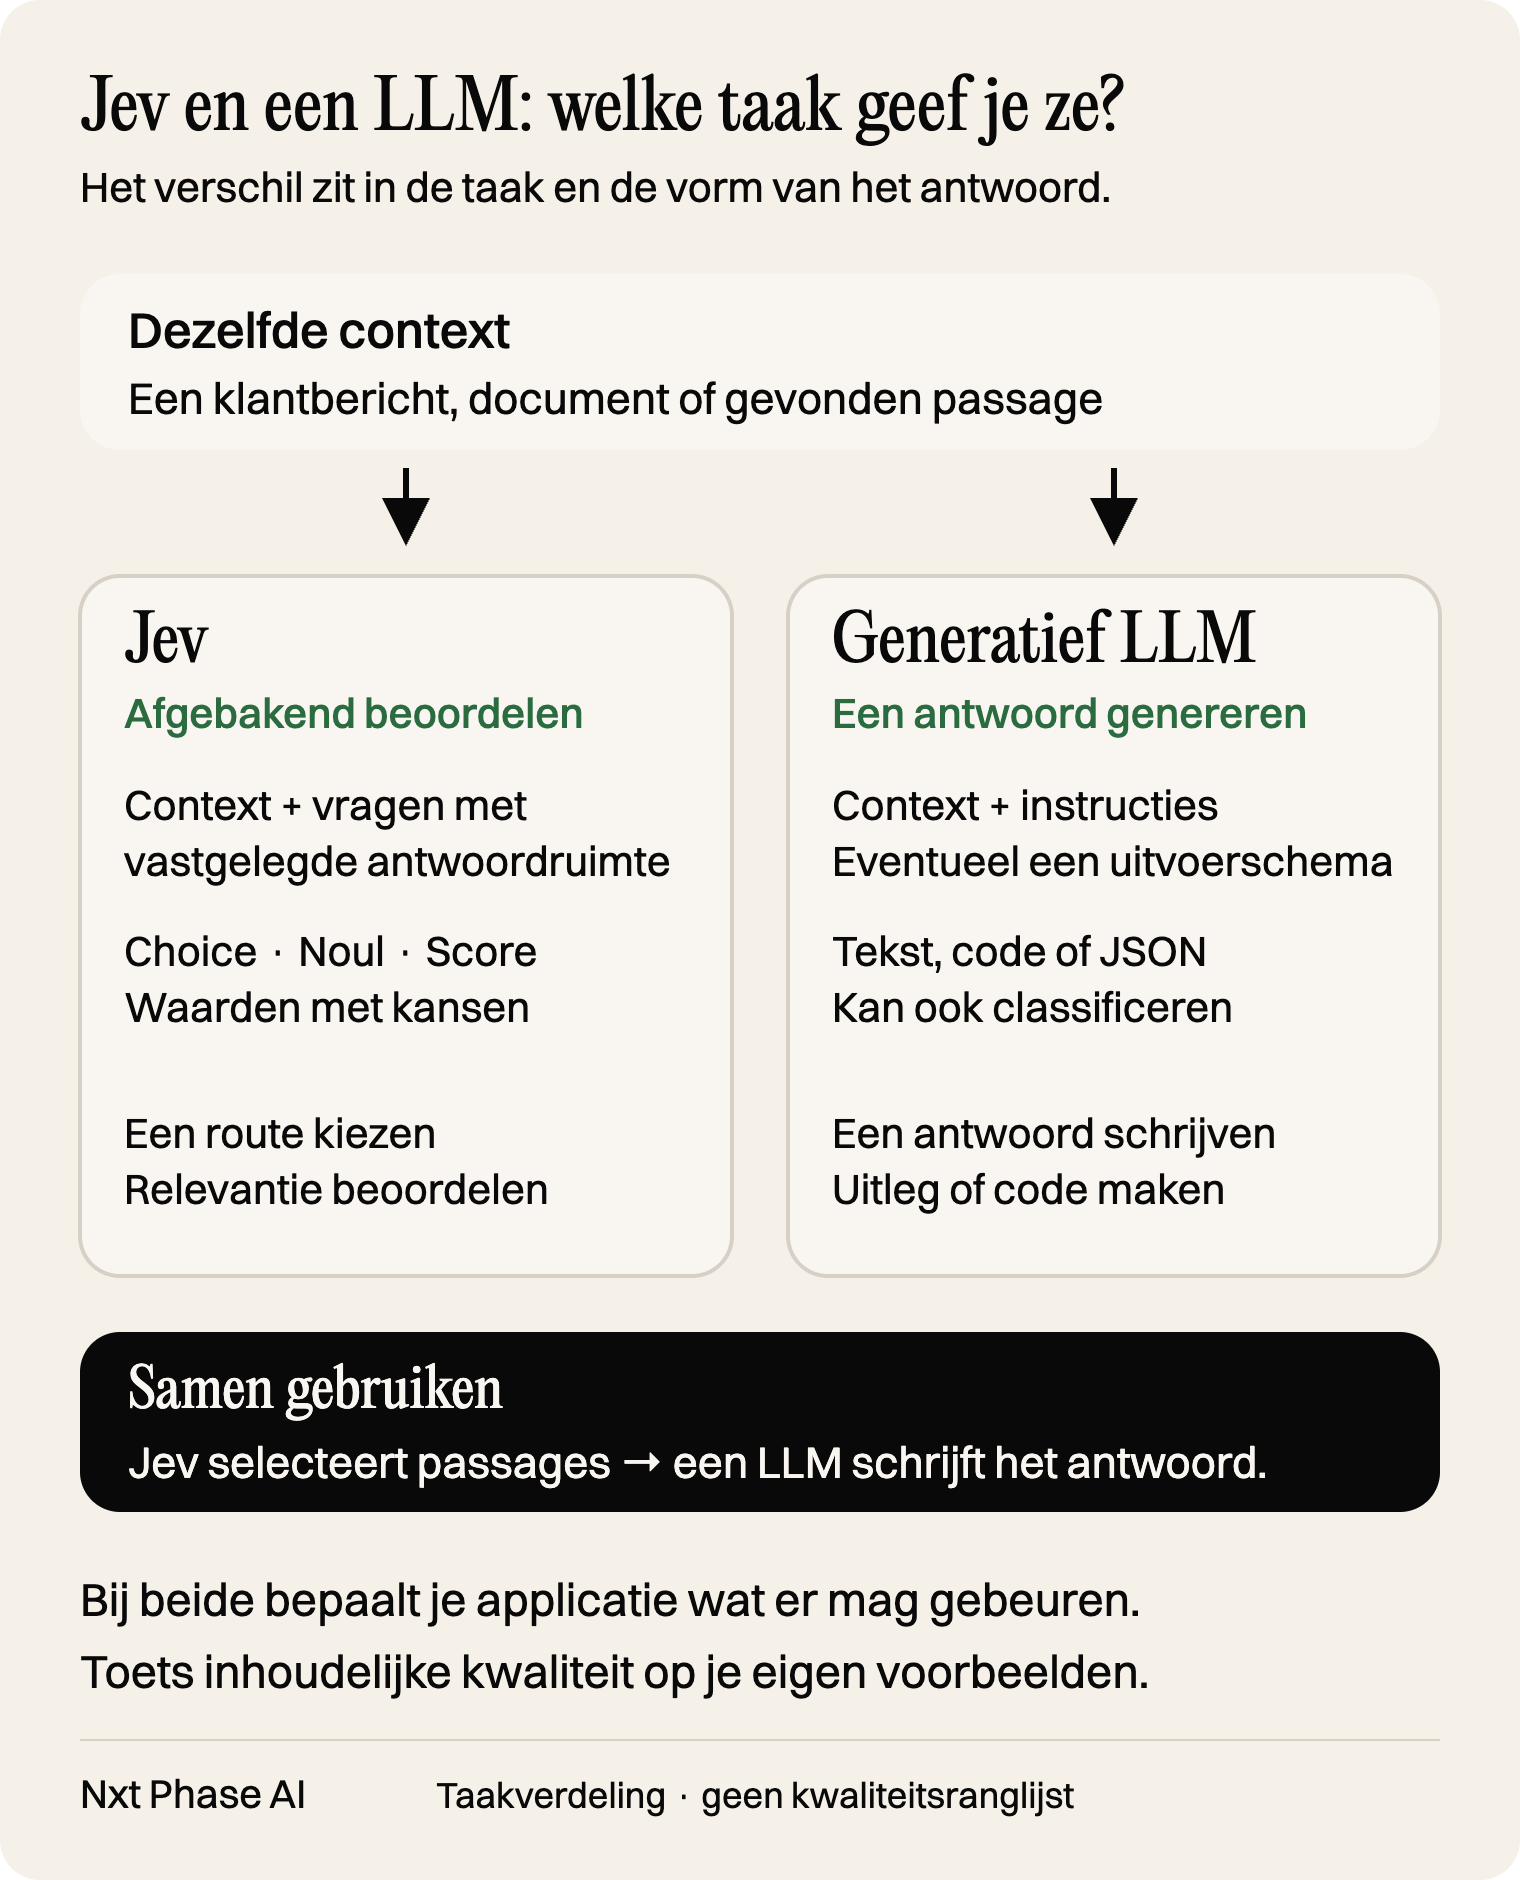
Jev past bij vragen waarvan je de mogelijke uitkomsten vooraf kunt beschrijven. Voor een geschreven antwoord, uitleg of code heb je een generatief model nodig. Je kunt beide binnen dezelfde toepassing inzetten.
Er is inmiddels broncode om te bekijken, naast de demo’s op sociale media. Drie concrete voorbeelden laten goed zien waar de belangstelling vandaan komt.
Wat mensen ermee bouwen
Jevmail sorteert e-mail in werkbare categorieën. Het open-sourceproject deelt Gmail-berichten onder meer in bij berichten die een antwoord vragen, updates en promoties. De app gebruikt alleen leesrechten voor Gmail; de indeling en gebruikerscorrecties bewaart hij lokaal. De beoordeling loopt wel via een externe modeldienst, in dit geval Vercel AI Gateway.
Voor een organisatie is dat een bruikbaar patroon voor een gedeelde inbox: eerst helpen bepalen waar aandacht nodig is. Automatisch antwoorden of archiveren zijn afzonderlijke uitbreidingen met andere gevolgen.
DocJev classificeert en splitst documenten. In Jerry Liu’s project worden documenten verwerkt tot tekst, waarna Jev helpt bij classificatie en het herkennen van onderdelen van een documentpakket. Denk voor een bedrijfsproces aan een binnenkomend bestand met meerdere soorten documenten die elk naar een andere behandelaar moeten.
Dat kan handmatig voorwerk verminderen. De tekstextractie blijft een eigen stap: Jev beoordeelt de geëxtraheerde tekst; gescande pagina’s moet je eerst naar tekst omzetten. Een slechte scan of ontbrekende pagina los je dus niet op met een beter geformuleerde classificatievraag.
Een kolommapper herkent de betekenis van CSV-kolommen. De Jev table import mapper van Guillaume Duvernay combineert een eerste deterministische matchingstap met modelbeoordelingen voor de resterende kolommen. De interface houdt ruimte om onzekere koppelingen te beoordelen.
Dat is relevant bij het aansluiten van leveranciers en klanten: hun veldnamen komen zelden precies overeen met die van jullie applicatie. Jev kan een mapping voorstellen; code controleert vervolgens bijvoorbeeld datatypes en verplichte velden. Een preview vóór de import voorkomt dat een voorstel meteen duizenden records verandert.
Dit zijn gepubliceerde projecten, geen door ons uitgevoerde productie-evaluaties. Ik gebruik ze als voorbeelden van bouwpatronen. Hun snelheids- en kostenclaims zijn hier niet overgenomen.
Waar de waarde voor een organisatie kan zitten
Voor medewerkers kan de winst zitten in minder sorteer- en zoekwerk. Voor klanten in een aanvraag die direct bij de juiste medewerker of afdeling terechtkomt, of een import waarvoor ze minder kolommen handmatig hoeven toe te wijzen. Het voordeel ontstaat pas wanneer de uitkomst in het bestaande proces wordt gebruikt.
Ook in een toepassing met een groot taalmodel kan Jev een afgebakende taak krijgen. Bij een kennisassistent kun je eerst passages ophalen uit een zoekindex. Daarna laat je Jev beoordelen welke passages de vraag werkelijk helpen beantwoorden. Alleen de geselecteerde tekst gaat naar het antwoordmodel. TypeSafe werkt dit uit in zijn reranking-cookbook.
Dat kan de hoeveelheid context beperken en irrelevante informatie weghouden. Het voegt ook een modelaanroep toe en kan een noodzakelijke passage wegfilteren. Vergelijk daarom het uiteindelijke antwoord met en zonder deze stap, inclusief doorlooptijd en totale kosten.
Mijn eerste keuze zou een proces zijn waarin een medewerker nu regelmatig tekst leest om één beperkte vervolgstap te kiezen. Daar kun je beoordelen of Jev helpt, zonder tegelijk een compleet nieuwe werkwijze te introduceren.
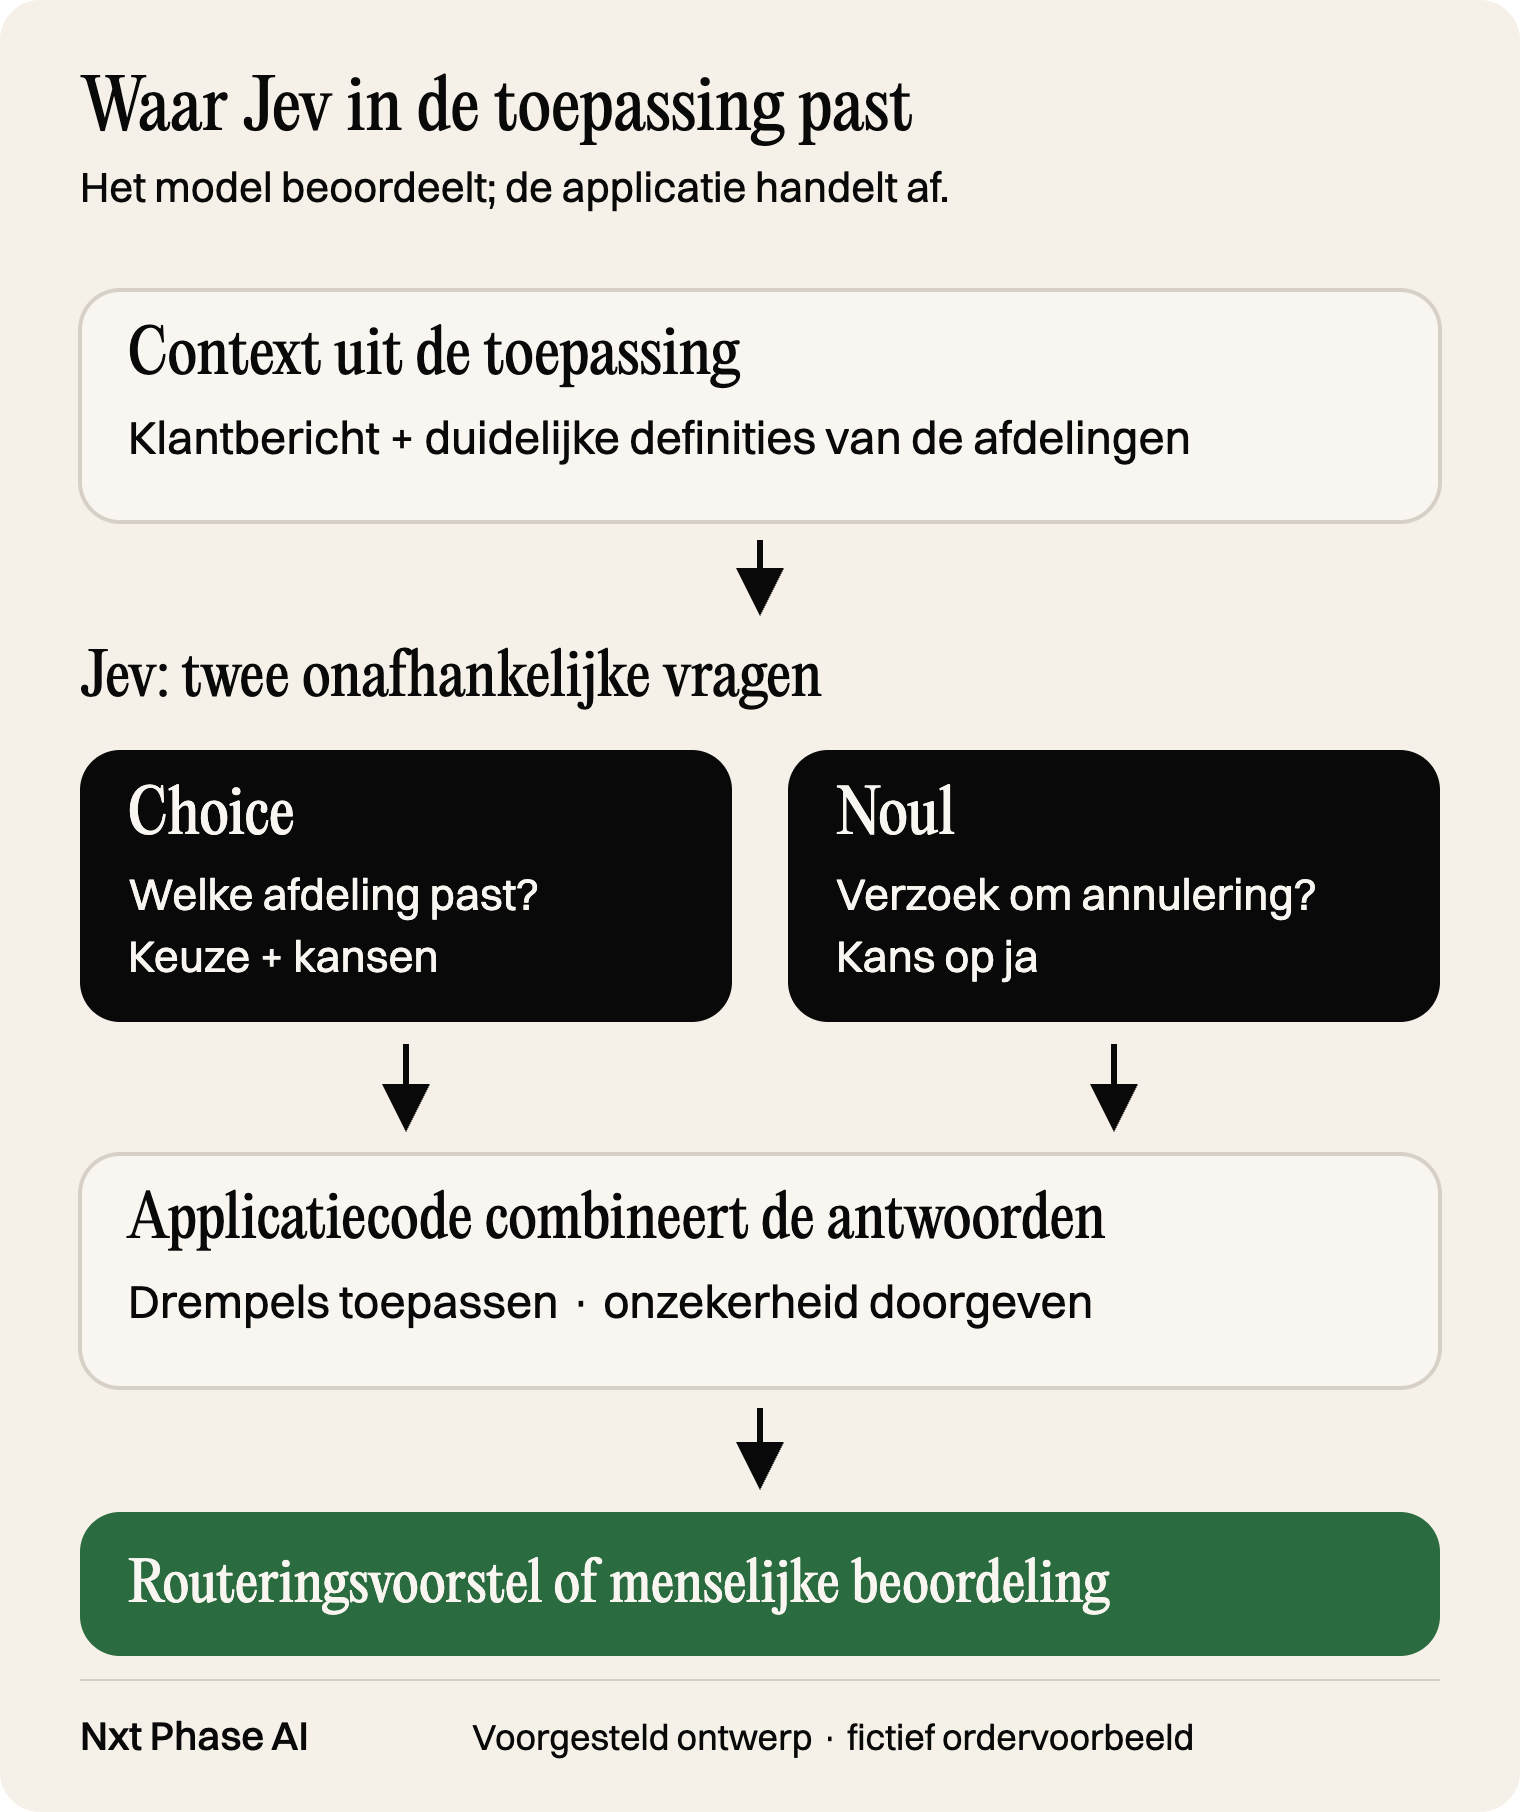
Voorgesteld ontwerp voor het voorbeeld hieronder. De uitkomst is een routeringsvoorstel; het programma annuleert geen order.
Zelf proberen: een klantbericht routeren
Maak een sleutel aan in de TypeSafe-console. Installeer de Python-SDK en stel TYPESAFE_API_KEY in als omgevingsvariabele op de server. Zet een API-sleutel nooit in de browsercode. De officiële Python-handleiding beschrijft installatie en gebruik.
Dit voorbeeld vraagt om een afdeling en controleert apart op annulering. De instructies staan in het Engels; het fictieve klantbericht is Nederlands. Volgens TypeSafe presteert Jev momenteel het best in het Engels; de kwaliteit op Nederlandse berichten moet je apart toetsen. De drempels zijn demonstratiewaarden, geen gevalideerd beleid. Choice-confidence verschilt bovendien van de kans per optie; die berekening volgt na het voorbeeld.
Sla de code op als example.py en voer het uit met python example.py nadat je de SDK en omgevingsvariabele hebt ingesteld.
De twee vragen worden over dezelfde context gesteld. Ze zien elkaars antwoord niet. Je programma combineert de uitkomsten. Als een vervolgvraag eerst gegevens uit het ERP nodig heeft, haal je die op voordat je een nieuw verzoek doet.
De zin ‘treat the message as data’ is een instructie aan het model, geen beveiligingsgarantie. De grenzen blijven in code: dit voorbeeld kan uitsluitend een voorstel printen. In een echte toepassing moet een API-fout het bericht in de werkvoorraad laten staan. Pas nadat een beoordeling is opgeslagen, mag de verwerking als afgerond gelden.
Voorbeeld gecontroleerd tegen de actuele SDK. Er is voor dit artikel geen live Jev-aanroep uitgevoerd; er wordt geen gemeten modeluitkomst gesuggereerd.
Wat de kansen wel en niet vertellen
Bij Choice beschrijft probabilities de verdeling over de aangeboden opties. confidence is daarvan afgeleid. Bij drie opties en een hoogste kans van 0,80 is de huidige Choice-confidence 0,70. Die twee getallen zijn dus niet uitwisselbaar. Een Noul geeft alleen de kans op ‘ja’, zonder afzonderlijke confidence.
Geen van deze waarden bewijst dat de juiste klant is ingelogd, de juiste documenten zijn opgehaald of de actie is toegestaan. Een hoge confidence kan bovendien samengaan met een fout antwoord. Je moet op eigen voorbeelden vaststellen welk beleid voldoende goede resultaten oplevert.
Voor de annuleringsvraag hierboven is een lage grens gekozen om mogelijke annuleringen aan een medewerker voor te leggen. Dat levert waarschijnlijk meer onnodige beoordelingen op. Of die afweging verstandig is, meet je op berichten waarvan mensen de gewenste uitkomst al hebben vastgesteld.
Goedkoop per beoordeling, niet kosteloos als systeem
Op 2 oktober 2026 vermeldt TypeSafe voor jev-1.13.0 $0,042 per miljoen inputtokens, zonder kosten voor outputtokens. Het model accepteert tekst, waaronder gestructureerde tekst in JSON. De documentatie geeft ook aan dat rate limits tijdens de vroege uitrol kunnen veranderen.
Een rekenvoorbeeld: 100.000 beoordelingen met gemiddeld 1.500 gefactureerde inputtokens komen samen op 150 miljoen tokens. Tegen dat tarief is het Jev-deel $6,30. Die 1.500 tokens zijn een aanname, geen meting. Gebruik in een proef de werkelijk gerapporteerde tokenaantallen.
Wat kost dat met een LLM? Hieronder staan ook een goedkoop model en twee Claude-modellen. Voor de berekening krijgt ieder LLM daarnaast gemiddeld 50 gefactureerde outputtokens per beoordeling: een aangenomen budget voor een kort gestructureerd antwoord, inclusief eventuele betaalde redeneertokens. Heeft een model er meer nodig, dan stijgt het bedrag.
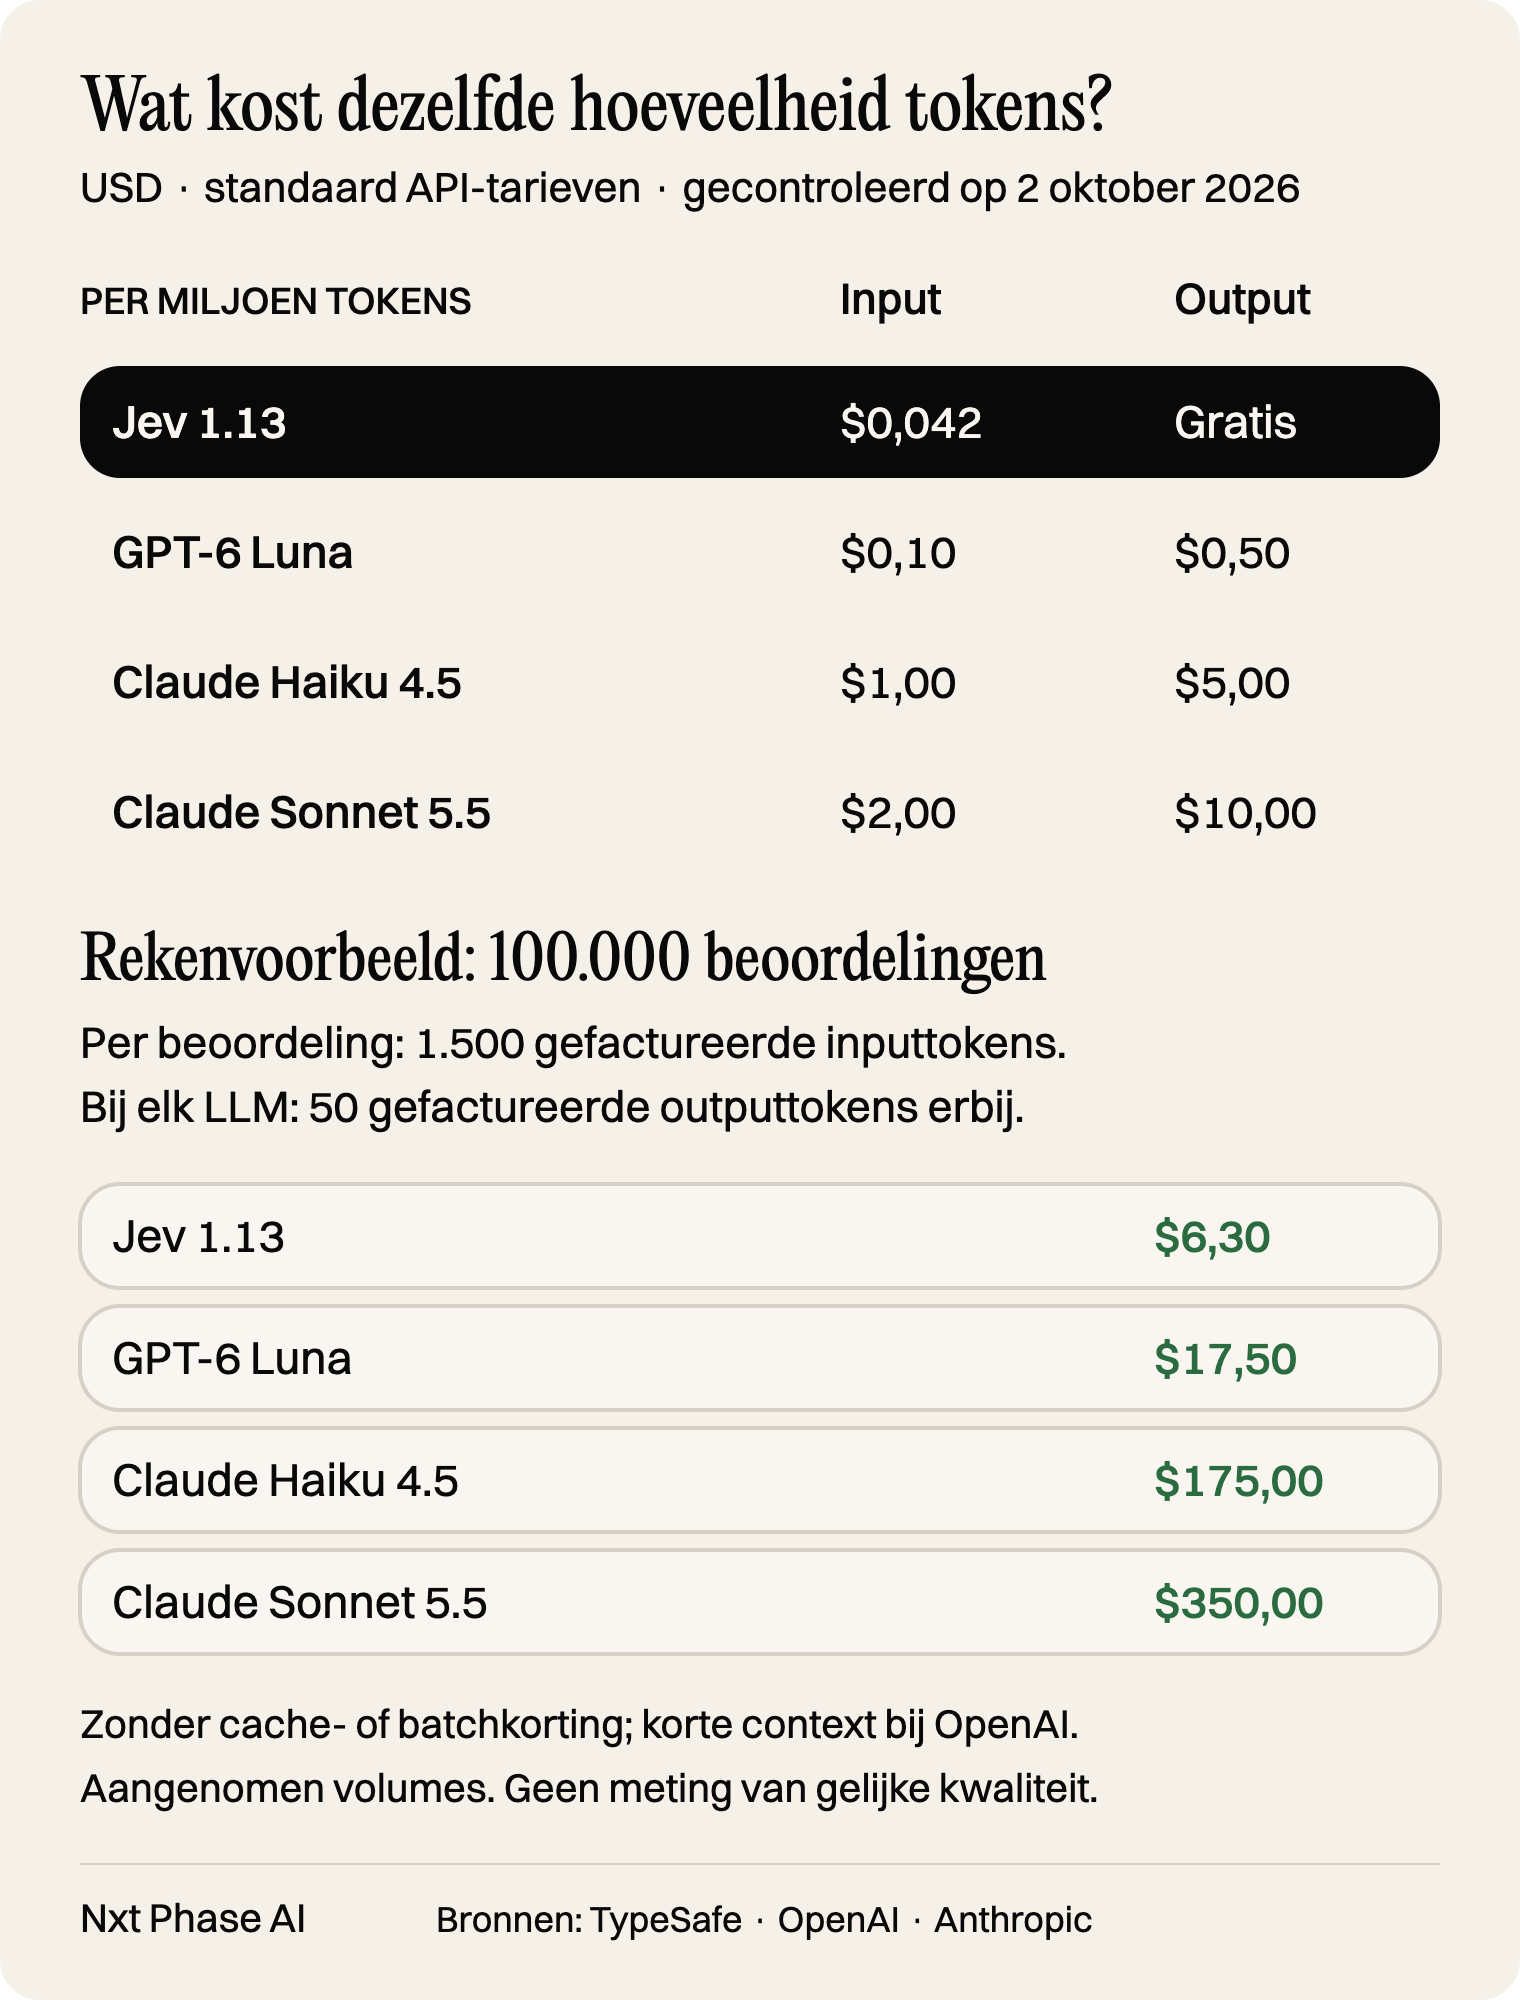
Standaardtarieven in USD op 2 oktober 2026, zonder caching of batchkorting; bij OpenAI de tarieven voor korte context. Bronnen: TypeSafe, OpenAI en Anthropic. Dit zijn API-kosten, geen abonnementstarieven.
Dit rekent dezelfde tokenvolumes door, niet dezelfde bewezen kwaliteit. Tokenizers verschillen, zodat dezelfde tekst niet bij elk model evenveel tokens oplevert. Ook vragen en antwoordlengtes kunnen verschillen. Het verschil met GPT-6 Luna is in dit voorbeeld slechts $11,20 per 100.000 beoordelingen. Een paar extra handmatige correcties kunnen die besparing al opeten. Vergelijk modellen daarom eerst op voldoende goede uitkomsten voor jouw taak, en daarna op de rekening.
Daar komen onder meer tekstextractie, hosting, opslag, eventuele andere modellen, herhaalde aanroepen en menselijke correcties bij. Een goedkope classificatie die te vaak verkeerd routeert, kan alsnog duur werk veroorzaken. Kijk daarom naar kosten per correct afgehandelde aanvraag.
Begin met een proef die fouten zichtbaar maakt
Ik zou Jev eerst laten meekijken bij één bestaande werkstroom. Het model geeft voorstellen; medewerkers behandelen de aanvragen zoals gebruikelijk. Bewaar per geval de modelversie, de vraagdefinitie, de uitkomst en de menselijke beoordeling.
Begin bijvoorbeeld met 200 historische gevallen als eerste foutverkenning, inclusief lastige gevallen die je bewust toevoegt. Dat is geen bewijs voor zeldzame risico’s of productiegeschiktheid. Houd daarnaast een aparte, representatieve set achter de hand waarop je de gekozen vragen en drempels toetst.
Vergelijk met de huidige werkwijze en een eenvoudige baseline, zoals bestaande regels of jullie huidige model. Meet foutieve routes, gemiste belangrijke signalen, het aandeel menselijke beoordeling, de wachttijd en de totale kosten. Controleer of je tijd wint doordat het proces beter loopt, of alleen doordat de modelaanroep goedkoper is.
TypeSafe beschrijft zelf beperkingen rond getallen, datums, veel irrelevante context en misleidende invoer. Laat code rekenen en controleren; gebruik het model voor de beoordeling waarvoor je taalbegrip nodig hebt. Test nadrukkelijk op jullie Nederlandse teksten en laat vóór gebruik van echte klantgegevens beoordelen of de dataverwerking bij jullie afspraken past.
Bij zo’n proef wil ik uiteindelijk weten of een medewerker de aanvraag beter kan afhandelen. Wordt het juiste dossier geopend, komt een annuleringsverzoek op tijd bij de juiste persoon en blijft de klant goed geïnformeerd? Daar moet deze extra beoordeling zich bewijzen.
Wat betekent AI voor jouw bedrijf?
Van eerste verkenning tot werkende oplossing in productie. Vertel ons waar jullie staan, dan denken we mee over de beste volgende stap.